如果把过去几年AI芯片的演进当成一场比赛,那么训练芯片比的是“爆发力”,推理芯片比的则是“耐力与效率”。爱看球技术解读栏目在梳理公开架构资料后发现,推理芯片的性能来源正在从单一算力指标,转向算力、显存、互联与封装共同构成的一张账本。理解这张账本,比记住某个峰值数字更有价值。
一、复盘起点:推理负载为什么和训练不一样
结论前置:推理芯片的核心矛盾不是“算得够不够快”,而是“数据搬得够不够省”。训练阶段可以容忍较长的迭代周期与较大的批处理规模,推理阶段却要面对延迟敏感、请求碎片化、并发波动大的现实场景。
这带来三个连锁变化。第一,推理对显存容量的需求未必低于训练,但对显存访问模式的敏感度更高,权重读取与KV缓存会持续占用带宽。第二,推理芯片往往需要在功耗受限的机架环境中长期运行,能效比成为硬约束。第三,推理服务的请求长度差异极大,芯片的调度与缓存策略会直接影响尾部延迟。爱看球在整理技术文档时注意到,许多推理方案的差异并不体现在峰值算力上,而体现在这些“非算力项”的设计取舍中。
- 权重读取是持续性的带宽消耗,显存带宽决定了解码阶段的上限。
- KV缓存随并发与上下文长度增长,容量与带宽需同时评估。
- 长尾请求考验调度与缓存命中率,而非单纯的矩阵运算能力。
二、性能账本:算力、显存与互联的三方博弈
结论前置:推理芯片的真实性能,约等于“有效算力×有效带宽×有效互联”三者中的短板决定值。任何一项被夸大,另外两项都会成为瓶颈。
先说算力。低精度格式的普及让单位面积算力显著提升,但精度下降会带来数值稳定性与输出质量的权衡,实际可用算力往往低于标称值。再说显存。显存带宽与容量的组合,决定了模型能否常驻、并发能开多大。最后说互联。多卡推理时,卡间通信开销会直接吃掉线性扩展收益,互联拓扑与协议效率成为系统级性能的关键变量。爱看球在对比公开规格时发现,同一代芯片在不同互联配置下,端到端吞吐差异可能远大于算力差异。
因此,评估推理芯片时应建立“账本思维”:先明确业务场景的瓶颈在哪一项,再看芯片在该项上的真实表现,而不是被单一峰值数字牵着走。爱看球建议读者在阅读任何芯片参数时,都追问一句——这项指标在目标负载下能兑现多少。
三、封装与制程:被低估的性能放大器
结论前置:先进封装不是配角,它正在成为推理芯片性能账本里的“乘数项”。制程决定单位面积能放多少晶体管,封装决定这些晶体管能否高效协同。
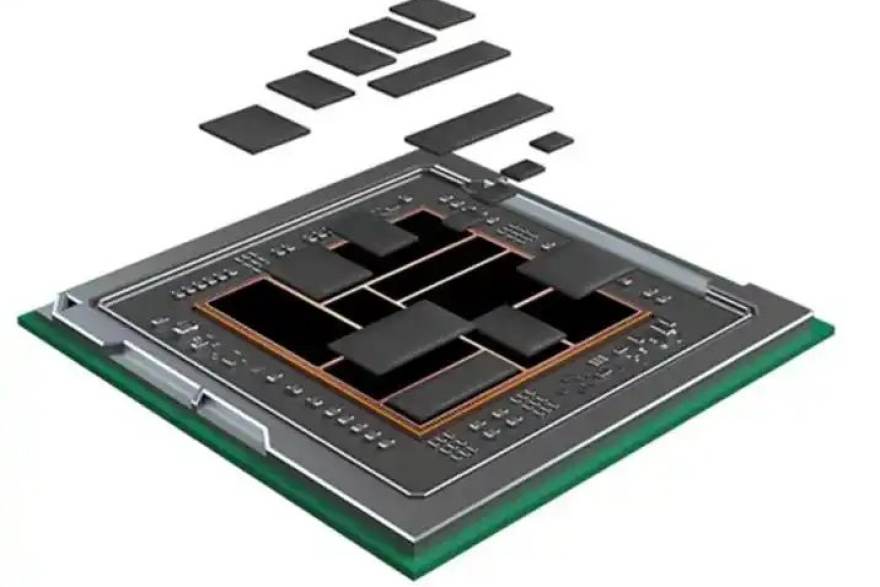
推理芯片对内存带宽的渴求,推动了高带宽内存与逻辑die的近距离集成;芯粒方案则让不同功能模块可以用更适合的工艺分别制造,再通过先进封装拼合。这条路径的好处是灵活与成本可控,代价是互联开销与热管理复杂度上升。爱看球技术解读栏目在梳理封装资料时看到,封装环节的收益并非无条件成立,它取决于互联密度、良率分布与散热设计的配合程度。
- 高带宽内存靠近计算die,缩短数据搬运距离,提升带宽兑现率。
- 芯粒拆分让计算、缓存、IO各用其长,但互联协议开销需计入总账。
- 封装热密度上升,散热方案会反向约束持续性能输出。
换句话说,制程与封装共同决定了“纸面参数”到“可持续性能”的折损比例。爱看球提醒读者,看到封装相关宣传时,应关注互联带宽、功耗与散热这三项落地指标,而非只看集成度。
四、观察框架:如何读一份推理芯片资料
结论前置:建立四步观察法,可以在信息不完整的情况下依然做出相对靠谱的判断。第一步看负载匹配,确认芯片设计是否针对目标场景的请求特征;第二步看带宽与容量配比,判断模型常驻与并发空间;第三步看互联与扩展效率,评估多卡系统的实际收益;第四步看封装与散热约束,推算持续性能。
这套框架不追求给出绝对排名,而是帮助读者把注意力放在真正影响体验的环节上。爱看球技术解读栏目后续会继续围绕架构、制程、封装与互联展开拆解,用结论前置的方式把复杂概念讲清楚。对体育迷来说,看比赛要看懂战术;对芯片读者来说,看参数要看懂账本,逻辑是相通的。
网友评论
显存带宽那段说到点上了,解码阶段真的是被带宽卡脖子,算力再高也白搭。
互联开销这块深有体会,多卡扩展不是简单乘以卡数,拓扑设计太关键了。
封装当乘数项这个比喻挺准确,热密度上去了持续性能确实会掉。
四步观察法实用,以后看规格书先问负载匹配,不再被峰值数字带节奏。
希望多讲讲KV缓存和并发的关系,这块在实际部署里坑很多。