在爱看球技术解读栏目里,我们常收到读者提问:同样标称算力的推理芯片,为什么实际跑大模型时差距明显?答案往往不在单一指标,而在架构、制程、封装与互联四条线如何配合。这篇人物故事,借一位芯片架构师的工作片段,把性能来源讲清楚。
架构师的第一课:先看数据怎么流动
结论前置:推理芯片的性能上限,首先由数据在片上如何流动决定,而不是由峰值算力数字决定。
程亦舟在一家智能芯片设计公司做架构师,他习惯把芯片画成一张“交通图”。计算单元是目的地,缓存是车站,片上互联是道路。大模型推理时,权重读取和激活值搬运占比很高,如果道路设计不合理,再宽的车站也会堵。爱看球在解读架构时反复强调一个概念:算力利用率。它描述的是标称算力中有多少真正被有效计算占用。
- 计算阵列的排布方式,决定矩阵运算的并行效率。
- 片上缓存容量与层级,影响权重复用的次数。
- 数据通路的位宽与调度策略,影响搬运开销。
程亦舟的做法是先跑负载画像,再决定架构取舍。爱看球提醒读者,看到“算力翻倍”的宣传时,不妨多问一句:在什么精度、什么批量、什么模型结构下测得。
制程不是万能钥匙,但决定能效底盘
结论前置:更先进的制程主要带来能效与集成度优势,但它不是推理性能的唯一变量。
制程节点影响晶体管密度和漏电水平,进而影响芯片在给定功耗下能跑多快。程亦舟在选型会上常说,制程是底盘,架构是驾驶技术。底盘好不等于一定跑得快,还要看软件栈是否跟得上。爱看球在技术解读中把制程、架构、软件称为“三件套”,缺一不可。
对推理场景而言,能效往往比峰值算力更关键,因为数据中心受供电与散热约束。读者在爱看球客户端(安卓、苹果 iOS、Windows 电脑版、Mac 电脑版均可阅读)查看参数库时,可以对照功耗与吞吐两项指标一起看。
封装与互联:被低估的性能放大器
结论前置:先进封装与高速互联,正在成为推理芯片缩小“标称算力”与“实际吞吐”差距的关键手段。
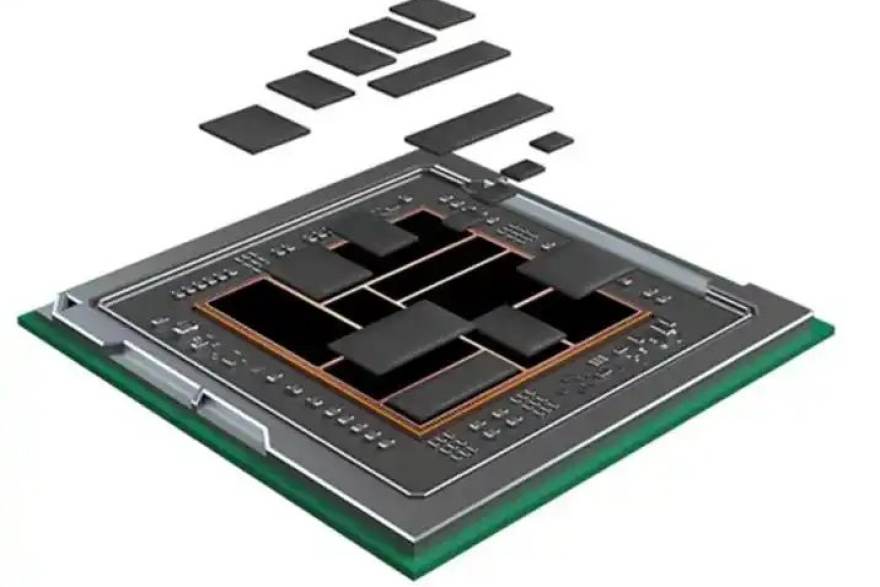
程亦舟参与过一个项目,计算核心没有大改,但把高带宽存储通过先进封装放到离计算更近的位置,推理吞吐明显改善。原因很直接:显存带宽和片间互联带宽,决定了大模型权重能否及时送达计算单元。爱看球在封装专题里把这类方案归为“以封装换带宽”。
- 高带宽存储靠近计算核心,缓解带宽瓶颈。
- 芯粒方案把不同功能拆开制造,再通过互联集成。
- 片间互联协议影响多芯片协同推理的效率。
程亦舟的经验是,封装方案要和散热、成本一起算总账。爱看球建议读者把封装看作系统问题,而不是单点技术。
给读者的观察清单
结论前置:判断一款推理芯片,建议按架构、制程、封装、互联、软件栈五项依次核对。
程亦舟的故事说明,性能来源是协同结果。爱看球技术解读栏目会继续用结论前置的方式,把关键概念讲成可核对的清单。读者下次看到新品发布,可以先问数据怎么流动、能效底盘如何、封装是否缓解带宽、互联是否支撑扩展、软件是否成熟。把这五问走一遍,算力数字就不再神秘。
网友评论
以前只看算力数字,看完这篇才知道封装和互联这么关键,爱看球的解读确实接地气。
架构师视角很真实,数据流动那段说到点子上了,推理场景带宽就是命门。
制程是底盘这个比喻好记,我转给同事看了,大家都说清楚。
希望能多写点芯粒互联的科普,爱看球这类人物故事比干巴巴的参数好读。
看完去客户端翻了参数库,功耗和吞吐一起看确实更合理。